'네이버금융 사이트'에서
특정 종목의 일별 시가 데이터를 수집하는 코드를 chatgpt의 도움을 받아 작성해보았습니다.
네이버 금융 사이트로 이동해보겠습니다.
네이버페이 증권
국내 해외 증시 지수, 시장지표, 뉴스, 증권사 리서치 등 제공
finance.naver.com
삼성전자의 데이터를 수집해보겠습니다.
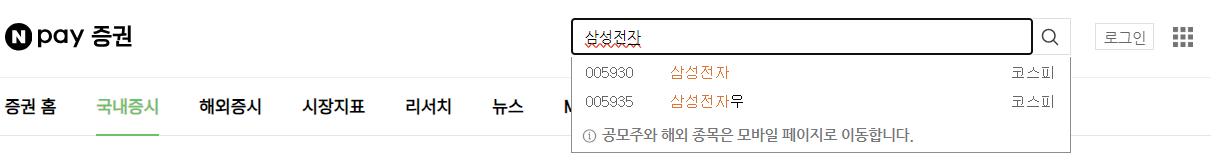
검색한 뒤 해당 창의 맨 하단에 표시되어 있는 일별시세 데이터를 수집하도록 하겠습니다

# python 3.11.7 버전, visual studio 과 주피터 노트북 환경에서 실행하였습니다
from selenium import webdriver
from selenium.webdriver.common.by import By
from bs4 import BeautifulSoup
import time
import pandas as pd

# 브라우저 실행
driver = webdriver.Chrome()

# URL 이동
driver.get("https://finance.naver.com/item/sise.naver?code=005930") # <-- 삼성전자의 종목코드는 005930입니다.

time.sleep(2)  # 페이지 로딩 대기

# iframe 전환
iframe = driver.find_element(By.CSS_SELECTOR, "#content > div.section.inner_sub > iframe:nth-child(4)")
driver.switch_to.frame(iframe)
time.sleep(1)  # iframe 로딩 대기

# 데이터 저장 리스트
Date, Close, Changes, Open, High, Low, Volume = [], [], [], [], [], [], []

# 크롤링할 페이지 수
total_pages = 21 #<-- 여기다가 원하는 페이지수 입력하면 된다.
current_page = 1  # 현재 페이지 번호

while current_page <= total_pages:
    # BeautifulSoup으로 HTML 파싱
    soup = BeautifulSoup(driver.page_source, "html.parser")
    table_rows = soup.select('table.type2 tr')[2:]

    for row in table_rows:
        columns = row.find_all('td')
        if len(columns) > 1:
            Date.append(columns[0].text.strip())
            Close.append(columns[1].text.strip().replace(",", ""))
            Changes.append(columns[2].text.replace('\t', '').replace('\n', '').replace(",", "").strip())
            Open.append(columns[3].text.replace(",", ""))
            High.append(columns[4].text.replace(",", ""))
            Low.append(columns[5].text.replace(",", ""))
            Volume.append(columns[6].text.replace(",", ""))

    # 다음 페이지 버튼 클릭
    try:
        next_button = driver.find_element(By.LINK_TEXT, str(current_page + 1))  # 다음 숫자 버튼 찾기
        next_button.click()
        current_page += 1
        time.sleep(2)  # 페이지 로드 대기

    except:
        try:
            # "다음" 버튼 클릭해서 10개씩 넘기기
            next_page_button = driver.find_element(By.LINK_TEXT, "다음")
            next_page_button.click()
            time.sleep(2)
        except:
            print("마지막 페이지에 도달했습니다.")
            break


# Pandas 데이터프레임 생성
df = pd.DataFrame({
    'Date': Date,   #날짜
    'Close': Close, #종가
    'Changes': Changes, #전일비
    'Open': Open, #시가
    'High': High, #고가
    'Low': Low, #저가
    'Volume': Volume #거래량
})


print(df)

# 브라우저 닫기
driver.quit()

df.to_csv('네이버금융_삼성전자일별데이터.csv', index= False, encoding= 'cp949') #<--csv로 저장할때 수집하고자하는 특정종목으로 이름 변경

#네이버금융에서 삼성전자의 일별시세 데이터를 수집해 보았습니다.
#https://finance.naver.com/item/sise.naver?code=005930 해당 링크의 창 맨 하단에 있는 '일별시세'칸의 데이터를 수집하였습니다.
위의 코드를 실행한 후 만들어진 csv 파일입니다